 alkahest
Descarga desde cualquier sitio
El registro de Ollama, Hugging Face, catálogos git curados o el fichero GGUF y la carpeta que ya tienes. Descargas reanudables, en paralelo y verificadas por digest.
pullsearchimport
Alkahest descarga, ejecuta y sirve modelos de IA en tu propio hardware. Un único binario compacto con una CLI al estilo Ollama, todas las APIs habituales en un mismo puerto y una app de escritorio para ver qué se ejecuta y dónde.
alkahest pull qwen3:8b && alkahest run qwen3:8b
El logotipo es un embudo dibujado como el símbolo alquímico del agua: los modelos llegan de cualquier sitio por la boca ancha, el núcleo guarda lo que está cargado y una sola gota sale por el vértice.
Sin entorno de Python ni contenedores obligatorios. Instalas un paquete y tienes el servidor, la CLI y la app de escritorio.
El registro de Ollama, Hugging Face, catálogos git curados o el fichero GGUF y la carpeta que ya tienes. Descargas reanudables, en paralelo y verificadas por digest.
Los modelos se cargan con la primera petición y se descargan tras un keep-alive, así que los inactivos no consumen nada. Varios a la vez, en GPU, CPU o repartidos entre ambas.
llama.cpp para GGUF, el fork de PrismML para los modelos ternarios Bonsai, vLLM para safetensors, whisper.cpp para voz y stable-diffusion.cpp para imágenes.
Ollama, OpenAI, Anthropic Messages y una API de decisiones en un mismo puerto. Los clientes, SDKs y agentes que ya usas funcionan cambiando solo la URL base.
Desde la propia máquina no hace falta clave; desde cualquier otra, sí. Claves con permisos, caducidad y límite por modelo, TLS, registro de uso y auditoría.
alkahest desktop abre una app nativa para explorar, descargar, ajustar y vigilar modelos, con icono en la bandeja. Usa la misma API que cualquier cliente.
Una interfaz densa, como un instrumento de precisión, hecha de forma nativa en Rust. El latón marca la acción importante; el verdete, lo que está en marcha.
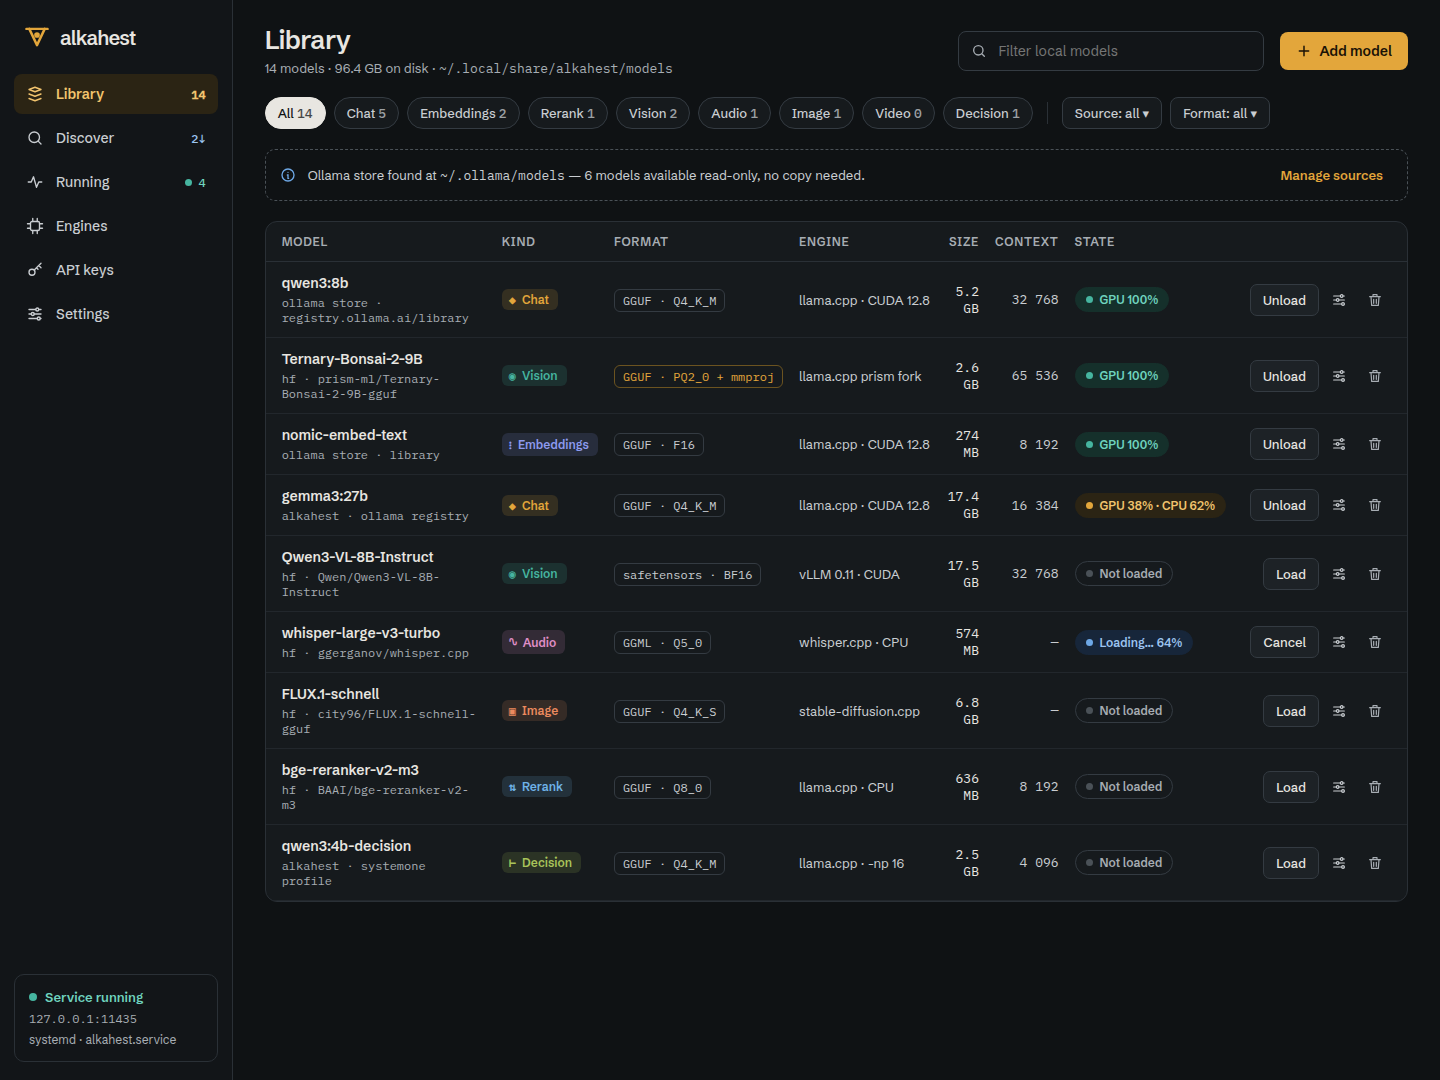
Todos los modelos locales en una tabla, incluidos los que ya tienes en Ollama.
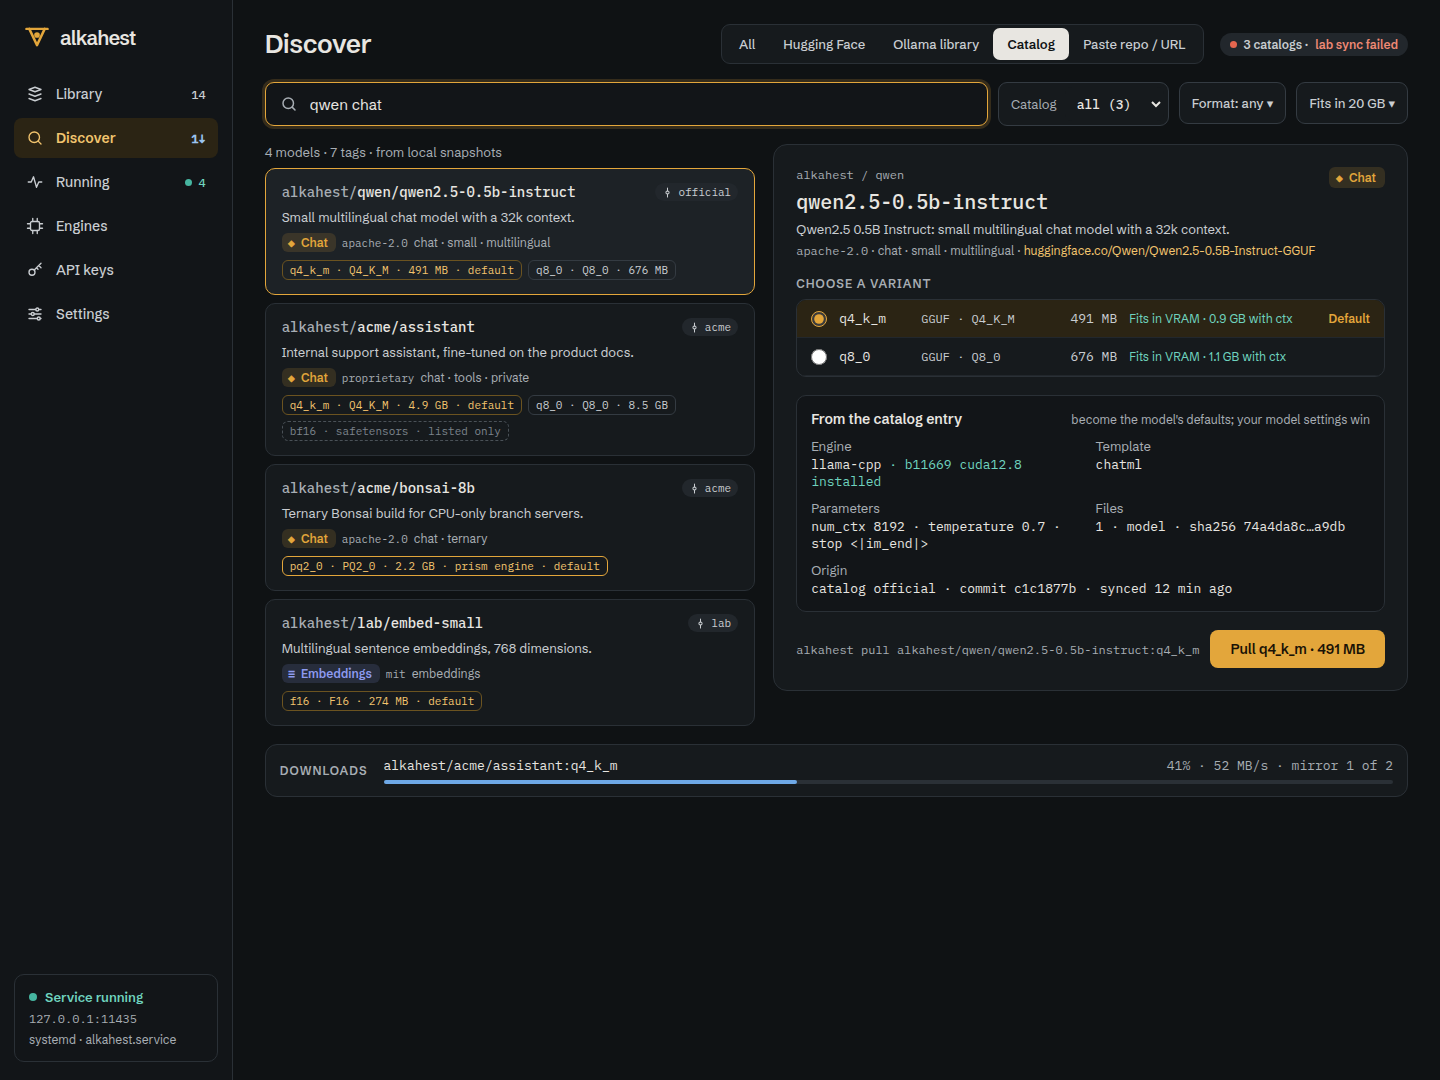
Busca en Hugging Face, la biblioteca de Ollama y tus catálogos git desde un solo cuadro.
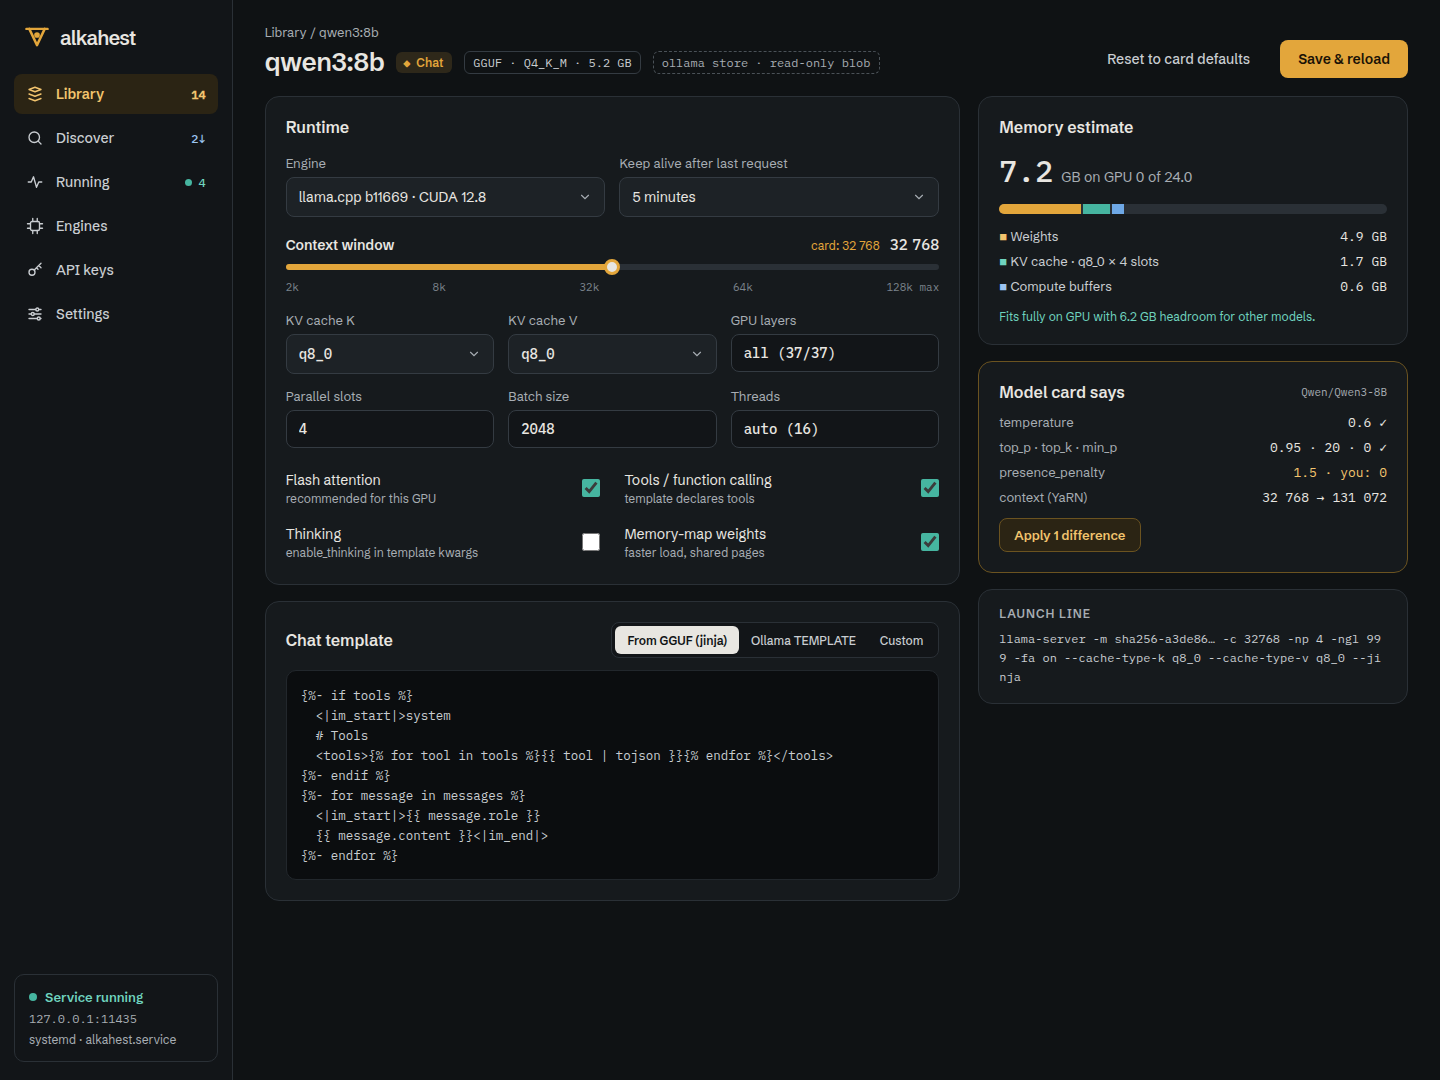
Ajustes por modelo con estimación de memoria en vivo.
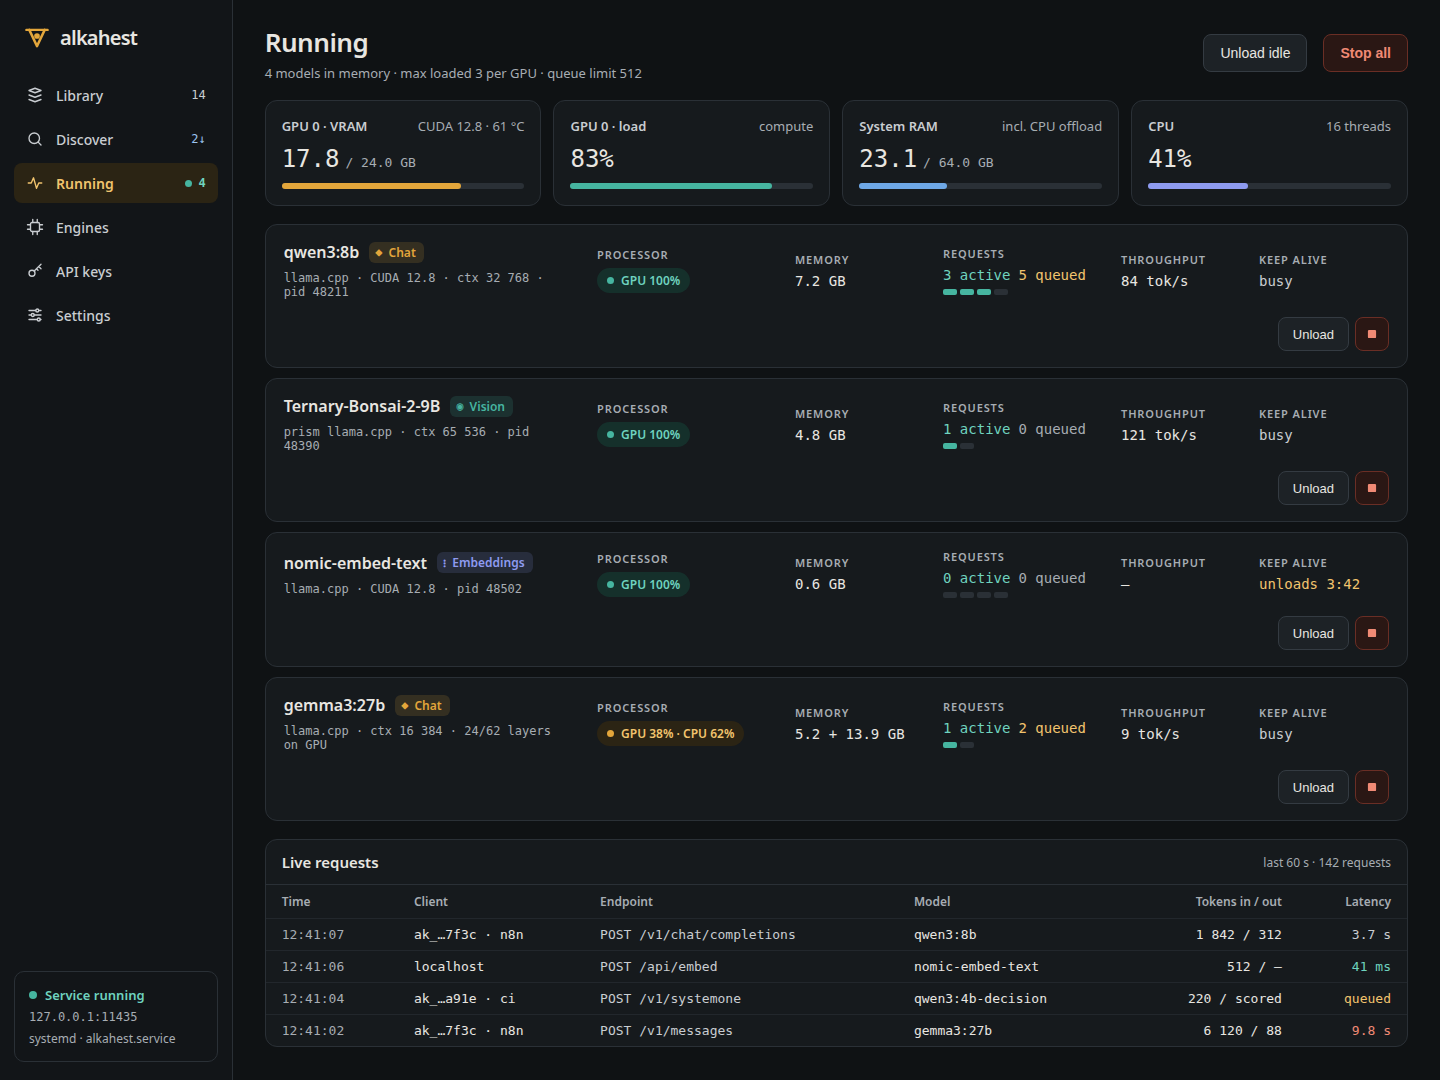
Qué está cargado ahora mismo y qué consume.
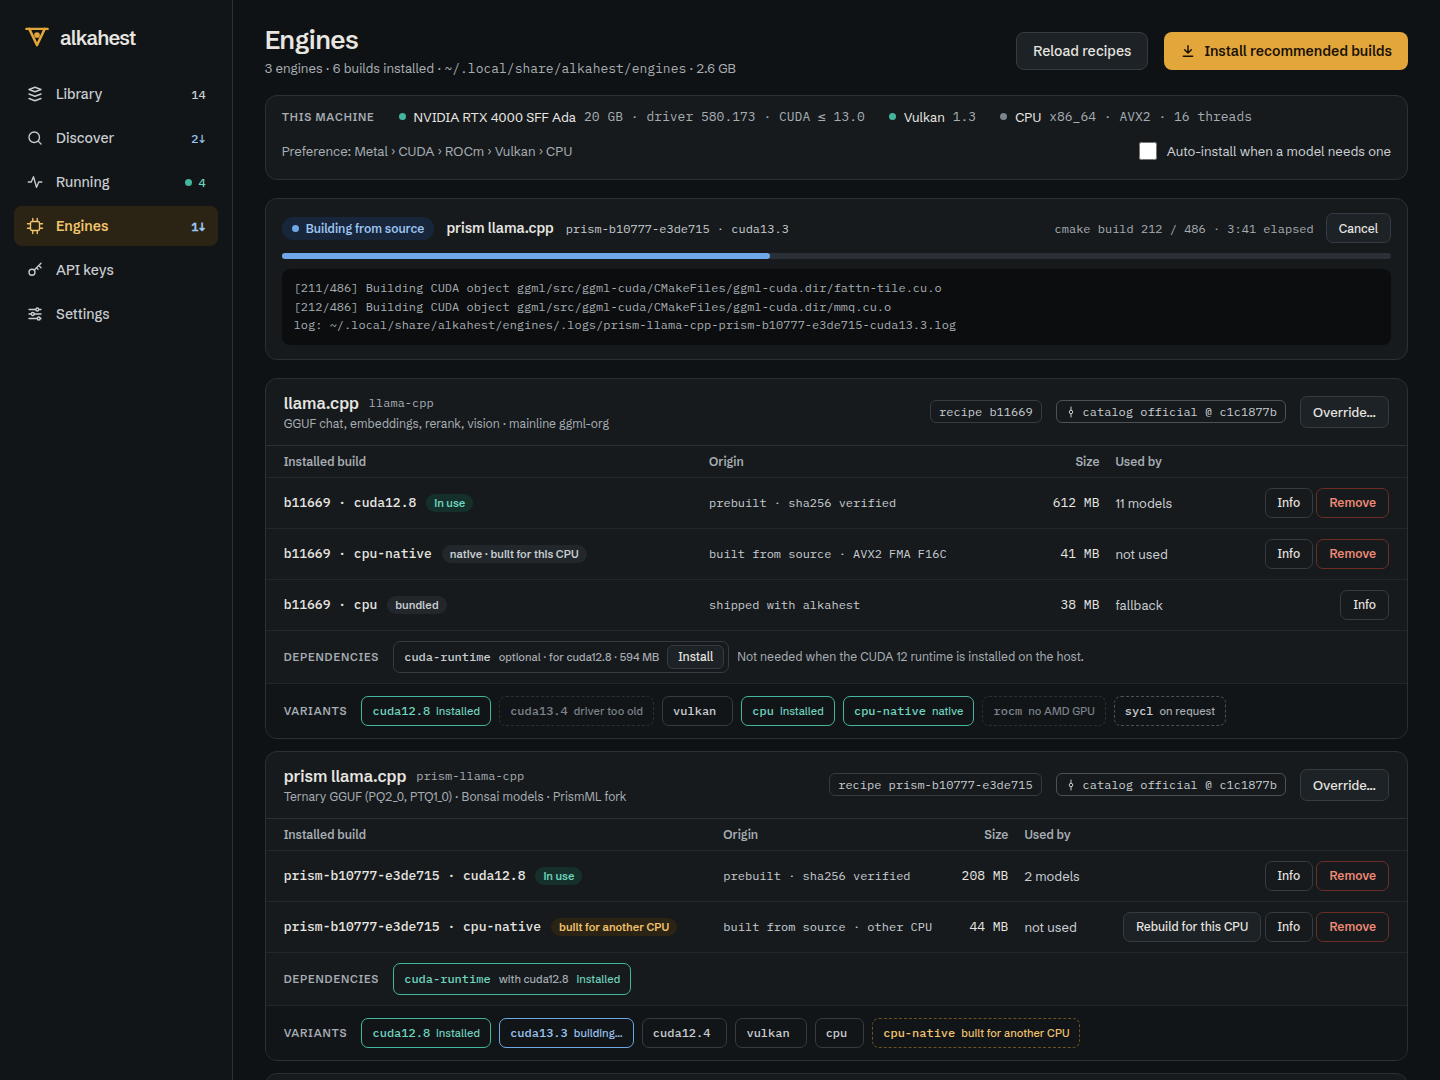
Instala la mejor build de cada motor para esta máquina.
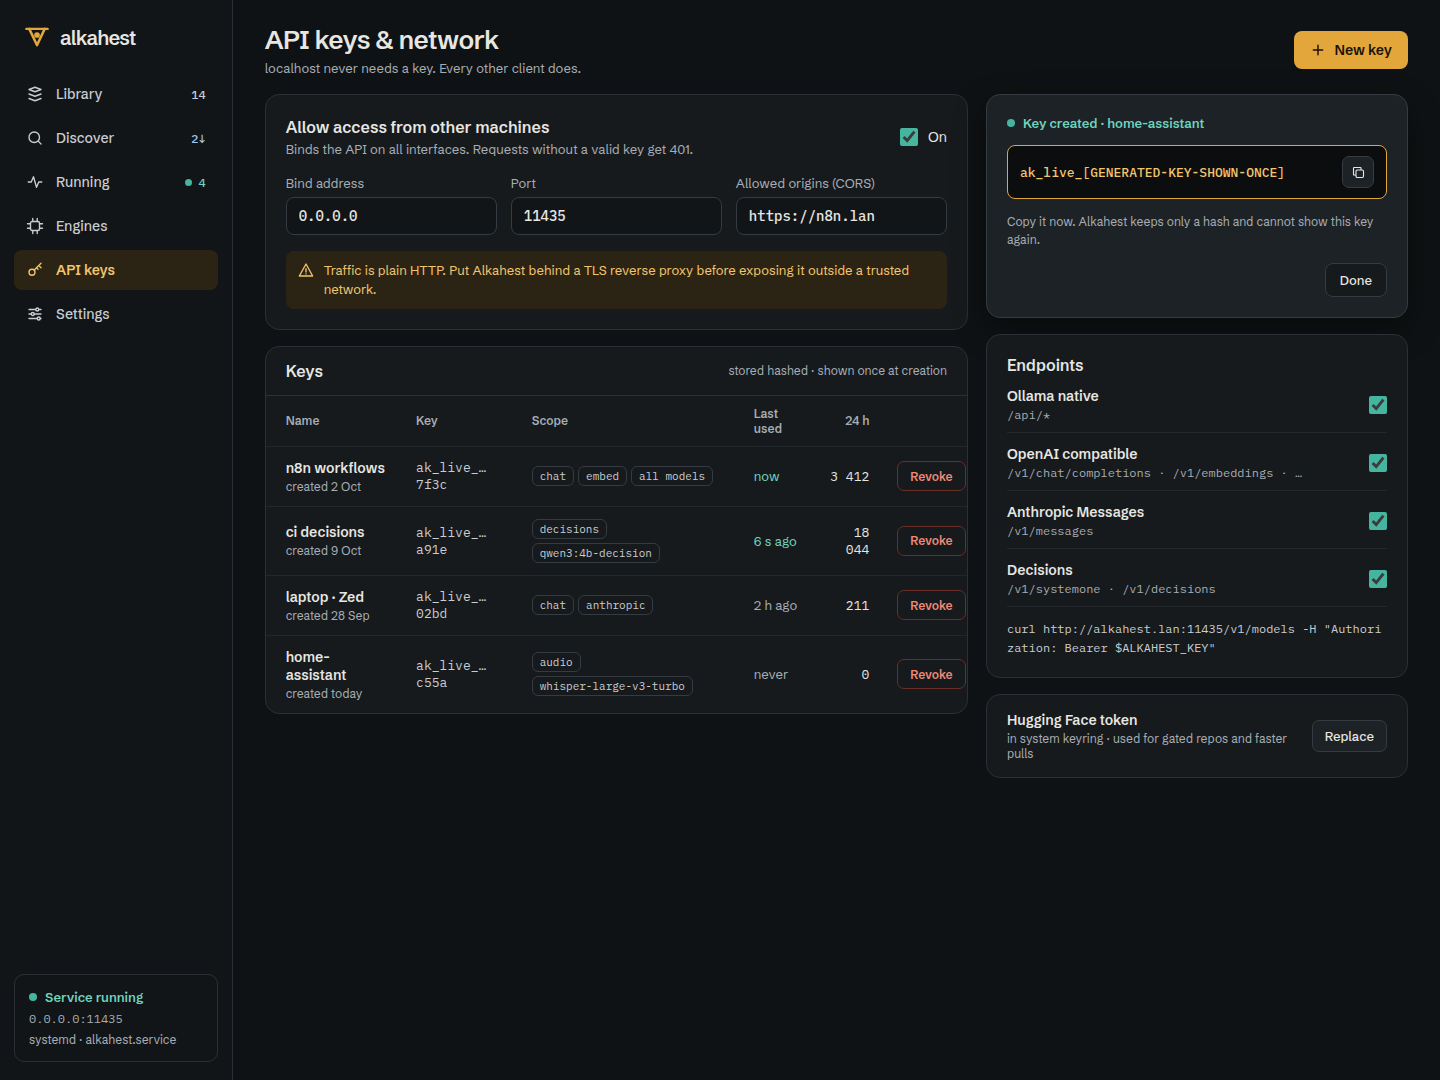
Comparte el servidor con otras máquinas de forma segura.
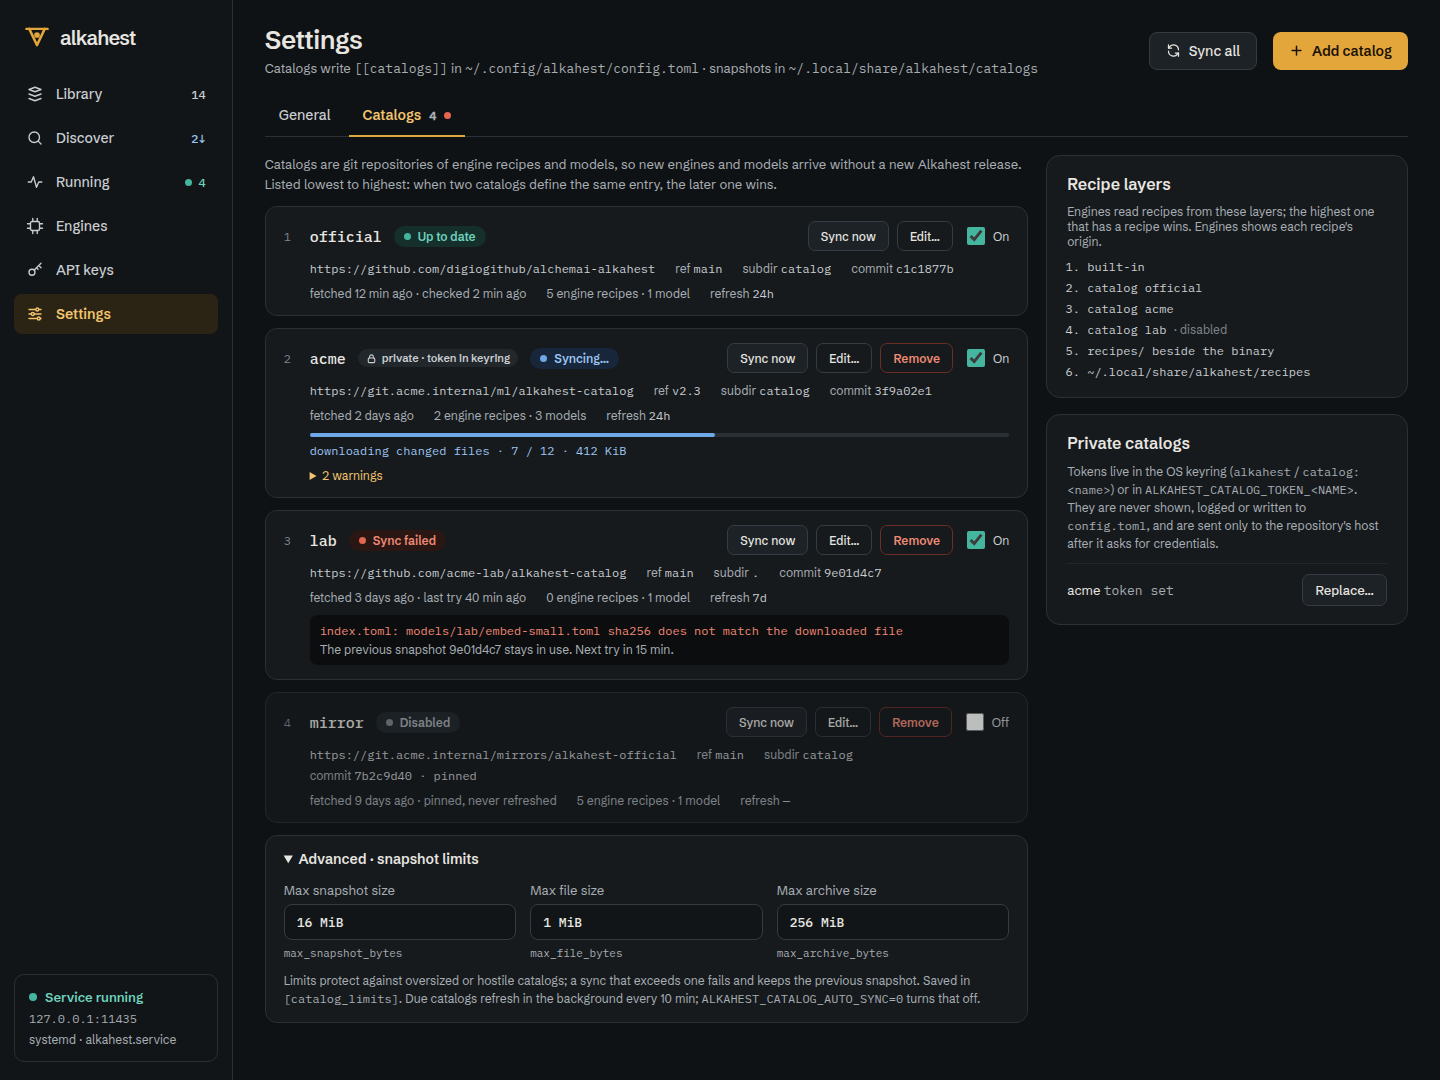
Listas curadas de modelos y recetas de motores leídas directamente de repositorios git.
Cada modelo se reconoce por lo que hace y se sirve por la API que le corresponde.
Los motores se ejecutan como subprocesos supervisados. Alkahest elige uno según el formato del modelo, descarga una versión precompilada o la compila para tu CPU a partir de una receta, y lo reinicia si se cae.
Todos los modelos GGUF: chat, visión con su proyector, embeddings y reranking. Todos los paquetes incluyen una build para CPU; las de GPU se instalan con un comando.
Modelos ternarios Bonsai en formato PQ2_0 y PTQ1_0, elegido automáticamente.
Modelos safetensors en Linux con NVIDIA, y en Apple Silicon donde está soportado.
Voz a texto en /v1/audio/transcriptions.
Generación de imágenes en /v1/images/generations.
alkahest engines install llama-cpp --native
Apunta cualquier cliente de Ollama, OpenAI o Anthropic a http://127.0.0.1:11435. El puerto 11435 es el siguiente al de Ollama, así que ambos pueden convivir.
POST/api/chat · /api/generate
POST/api/embed · /api/pull
GET/api/tags · /api/ps · /api/versionPOST/chat/completions · /responses
POST/embeddings · /rerank
POST/audio · /images
GET/modelsPOST/messages · /messages/count_tokensPOST/decisions · /systemonefrom openai import OpenAI client = OpenAI(base_url="http://127.0.0.1:11435/v1", api_key="unused-on-loopback") reply = client.chat.completions.create( model="qwen3:8b", messages=[{"role": "user", "content": "Why is the sky blue?"}], ) print(reply.choices[0].message.content)
curl http://127.0.0.1:11435/api/chat -d '{
  "model": "qwen3:8b",
  "messages": [{"role": "user", "content": "Hello"}]
}'

# cualquier cliente de Ollama: OLLAMA_HOST=127.0.0.1:11435
import anthropic

c = anthropic.Anthropic(base_url="http://127.0.0.1:11435", api_key="alk_...")
m = c.messages.create(
    model="qwen3:8b", max_tokens=200,
    messages=[{"role": "user", "content": "Hello"}],
)
# respuestas deterministas con probabilidades, puntuadas a partir de logits
curl http://127.0.0.1:11435/v1/decisions -d '{
  "model": "tev1:0.8b",
  "input": "I was charged twice for my order.",
  "questions": [
    {"type": "choice", "name": "route",
     "choices": [{"value": "billing"}, {"value": "shipping"}, {"value": "technical"}]},
    {"type": "predicate", "instructions": "Is the customer angry?"}
  ]}'
alkahest pull qwen3:8b                         # registro de Ollama
alkahest pull hf.co/ggml-org/tiny-llamas:Q4_0  # Hugging Face
alkahest pull alkahest/qwen/qwen2.5-0.5b-instruct  # catálogo git
alkahest import ~/models/qwen2-vl/ --link      # una carpeta, sin copiar
alkahest serve                                 # 127.0.0.1:11435
alkahest ps                                    # qué está cargado
alkahest keys create laptop --expires 30d      # compartirlo
Escrito en Rust. La CI impone límites de tamaño y de tiempo de arranque, y cada release se compila y se prueba en Linux, macOS y Windows.
serve listo en 500 msLos motores hablan HTTP en su propio proceso. Un fallo nunca tumba el servidor, y un vigilante detiene los motores si el servidor muere.
Admisión según la memoria estimada, expulsión de modelos inactivos, colas y slots paralelos por modelo, descarga tras keep-alive.
Blobs por digest SHA-256, compartidos entre modelos y con recolección de basura. El store de Ollama se lee, nunca se escribe.
Instrucciones de la CPU, RAM, NVIDIA mediante NVML cargado en tiempo de ejecución, AMD, Vulkan y Metal: la build y el reparto adecuados.
Recetas y modelos descargados por HTTPS, fijados a un commit y comprobados contra un índice de digests.
GPUI, acelerado por GPU, en el mismo binario. Habla con el servidor por HTTP como cualquier otro cliente.
En local, sin fricción. Todo lo demás necesita una clave.
alkahest serve --host 0.0.0.0:11435
Todos los paquetes incluyen una build de llama.cpp para CPU, así que funciona nada más instalarlo. Libre y de código abierto bajo licencia MIT.
curl -fsSL https://raw.githubusercontent.com/digiogithub/alchemai-alkahest/main/scripts/setup/install.sh | bash
# detecta tu sistema, CPU y GPU e instala la mejor build del motor; --service lo arranca al iniciar sesión
irm https://raw.githubusercontent.com/digiogithub/alchemai-alkahest/main/scripts/setup/install.ps1 | iex
docker build -t alkahest .
docker run -d --name alkahest -p 11435:11435 \
  -e ALKAHEST_API_KEY="$(openssl rand -hex 32)" \
  -v alkahest:/var/lib/alkahest alkahest
git clone https://github.com/digiogithub/alchemai-alkahest && cd alchemai-alkahest
cargo build --release -p alkahest --no-default-features   # servidor y CLI
cargo build --release -p alkahest --features desktop      # con la app de escritorio
alkahest update actualiza a la última versión.Guía de instalación →
Instálalo una vez y todas tus herramientas locales tendrán un servidor de modelos.
Descargar Alkahest